從感測器到果蠅大腦:
仿果蠅電子鼻的全部程式
這份教學說明四件事:(1) 用 UIFlow 2 讀 BME688、SGP30、SCD40;(2) 用 USB 線(UART)或 WiFi 把資料傳到筆電;(3) 用 2026 年發表的雄果蠅完整中樞神經連結體建立蕈狀體模型;(4) 研究計畫 E1–E8 每一個實驗的分析程式。所有程式都在 code/ 資料夾,網頁上的程式碼直接讀取原始檔,永遠是最新版。
系統架構:資料怎麼流動
| 資料夾 | 內容 |
|---|---|
code/firmware/ | UIFlow 2 程式:enose_logger.py(傳資料)、enose_classifier.py + mb_infer.py(獨立判斷) |
code/record.py | 筆電接收程式(USB 序列埠或 WiFi UDP),帶你走完採樣 SOP |
code/enose/ | 共用套件:資料格式、特徵萃取、蕈狀體模型、比較方法、連結體、模擬資料 |
code/experiments/ | 每個實驗一支分析程式,輸出表格與圖到 <資料夾>/results/ |
code/data/connectome/ | 從真實果蠅連結體抽出的 PN→KC 接線表(已附在專案裡) |
code/tests/ | 自動測試 |
筆電環境準備(Python)
- 安裝 Python 3.11 以上(Windows 安裝時勾選「Add Python to PATH」)。
- 下載並解壓縮程式,打開終端機(Windows:PowerShell),進到
code資料夾。 - 建立虛擬環境並安裝套件:
# macOS / Linux
python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt

# Windows PowerShell
py -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt- 確認一切正常:
python -m pytest -q,應顯示25 passed。 - 還沒有感測器也能練習:先產生模擬資料並跑一次完整流程。
python experiments/make_demo_data.py             # 產生 data/demo_calibration 與 data/demo_banana(模擬)
python experiments/make_features.py data/demo_calibration
python experiments/make_features.py data/demo_banana
python experiments/e2_compare_methods.py data/demo_calibrationUIFlow 2 感測器程式
第一次設定 M5Stack
- 用 M5Burner 把 UIFlow 2 韌體燒進 Core2(或 CoreS3),燒錄時填入 WiFi 名稱與密碼。
- 開啟 UIFlow 2 網頁編輯器(
uiflow2.m5stack.com),用裝置上顯示的 API Key 連線。 - 接線:三個 Unit 用 Grove 分接器一起接到 Port A(紅色)。I²C 位址不衝突:BME688
0x77、SGP300x58、SCD400x62。 - 在 Blockly 模式可以從 Unit 的「+」加入 ENV Pro、TVOC、CO2,選 I2C0/Port A,積木會出現在 Unit 分類下。本研究用 Python 模式,因為要輪流切換加熱溫度,積木寫起來很長。
三個 Unit 在 UIFlow 2 的程式寫法
以下 API 是研究助手直接讀 M5Stack 官方 uiflow-micropython 原始碼(2026-09-18 版)整理的,標「推論」的部分尚未確認。
| 用途 | 程式 | 注意 |
|---|---|---|
| Port A(Core2) | I2C(0, scl=Pin(33), sda=Pin(32), freq=100000) | CoreS3 是 scl=Pin(1), sda=Pin(2) |
| BME688 | env = ENVPROUnit(i2c0)env.get_gas_resistance()(kΩ)env.get_temperature() / get_humidity() / get_pressure()env.set_gas_heater(溫度°C, 毫秒) | 一次只能設一個加熱溫度;2 秒內重讀會拿到舊值。沒有 Bosch 的多段加熱與 BSEC。 |
| SGP30 | tvoc = TVOCUnit(i2c0)eco2, tvoc_ppb = tvoc.measure_iaq()h2, ethanol = tvoc.measure_raw() | measure_iaq() 要每秒呼叫一次,它內建的基準演算法才會正常。開機前 15 秒數值固定。 |
| SCD40 | co2 = CO2Unit(i2c0)co2.set_start_periodic_measurement()if co2.is_data_ready(): co2.co2 | 約 5 秒一個新值。原始碼的溫度解析有錯(低位元組取錯),溫濕度改用 BME688 的。 |
| 螢幕 | Widgets.Label(...)、label.setText(...) | UIFlow 2 產生的程式都用這種寫法 |
| USB 傳輸 | print("D,...") | 開機訊息也會出現在序列埠,所以資料行前面加 D, 讓筆電分辨(推論) |
| WiFi 傳輸 | socket.socket(AF_INET, SOCK_DGRAM).sendto(...) | UIFlow 2 開機會用燒錄時存的 WiFi 自動連線 |
為什麼 BME688 每 3 秒才讀一次
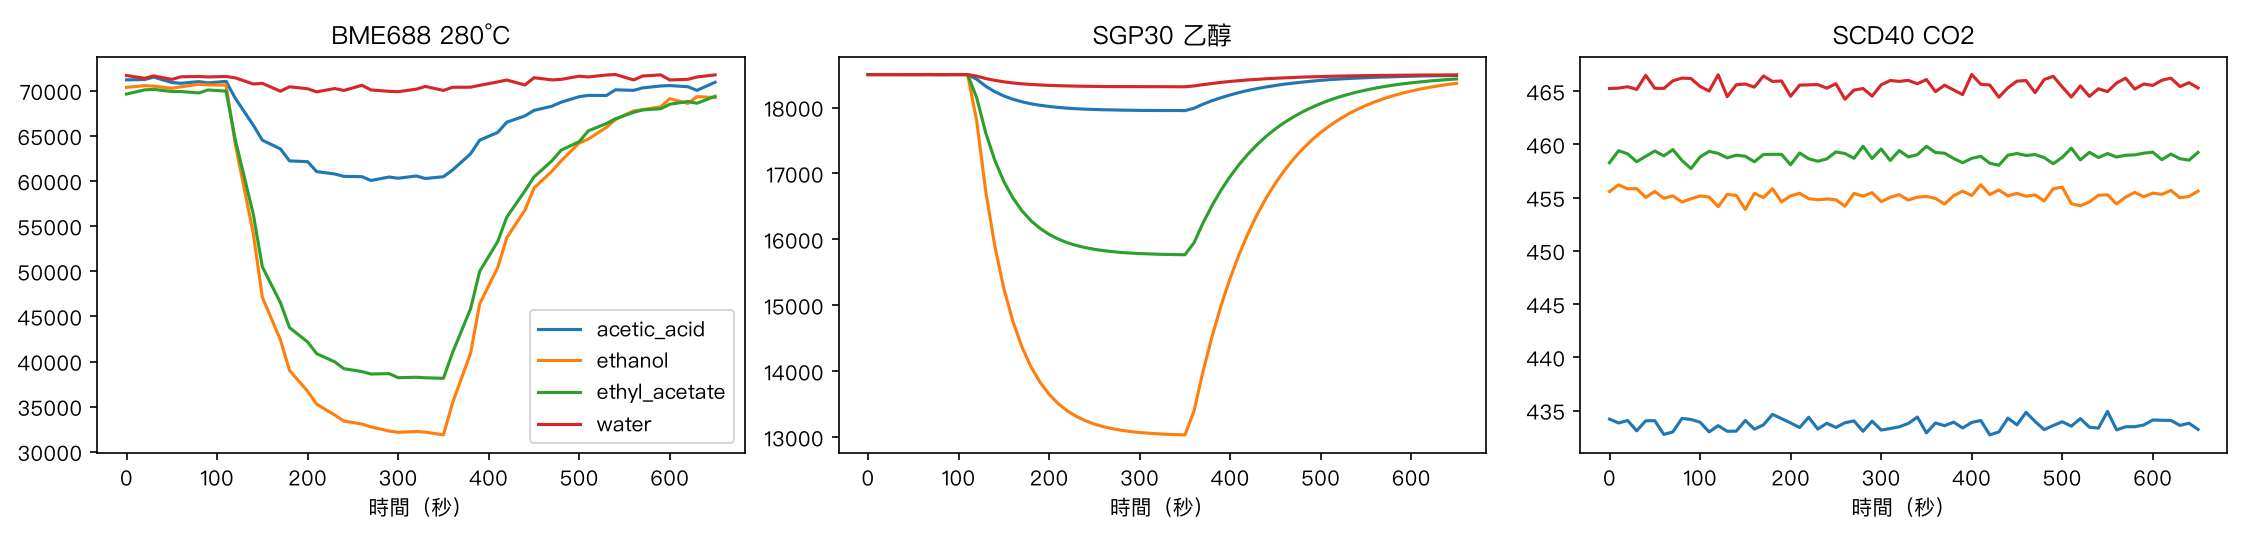
金屬氧化物感測器在不同加熱溫度下對不同氣體敏感,所以同一顆 BME688 換 5 種溫度,就像有 5 顆不同的感測器。UIFlow 2 的驅動一次只能設一個溫度,而且 2 秒內重讀會回傳上一次的快取,所以程式每 3 秒讀一次、讀完立刻換下一段溫度,15 秒輪完一圈。沒有讀 BME688 的那幾秒,資料行的 step 欄填 -1。
記錄器程式 enose_logger.py
把整份貼進 UIFlow 2 的 Python 編輯器,改最上面的設定(TRANSPORT、LAPTOP_IP、BOARD),按「Run」測試,確定沒問題再按「Download」存進裝置。
上機後第一次檢查
- 螢幕上
gas0…gas4輪流出現,而且數字彼此不同(溫度越高電阻通常越低)。如果連續兩次一模一樣,代表讀到快取,把BME_PERIOD_S改成 4;之後匯出模型時也要加--bme-period 4,讓獨立判斷程式用同樣的節奏。 - 對著盒子哈一口氣或靠近酒精棉片:
eth應該明顯下降(SGP30 的原始訊號在有乙醇時變小),co2應該上升。 - 如果
eth和h2反應看起來對調,把measure_raw()的兩個變數對調(原始碼的回傳順序是研究助手讀出來的,尚未上機確認)。
傳到筆電:UART(USB 線)或 WiFi
UART/USB 序列埠(建議先用)
- 最穩定、不用設網路。
- 韌體設
TRANSPORT = "serial",資料用print()送出,鮑率 115200。 - 要先關掉 UIFlow 網頁的連線,同一時間只有一個程式能開序列埠。
- 缺點:M5Stack 要一直接著筆電。
WiFi(UDP)
- 採樣盒可以放遠一點,筆電不用接線。
- 韌體設
TRANSPORT = "udp",LAPTOP_IP填筆電的 IP(macOS:系統設定 → Wi-Fi → 詳細資訊;Windows:ipconfig)。 - 筆電與 M5Stack 要在同一個 WiFi;第一次執行時防火牆詢問要按「允許」。
- UDP 掉封包不會重送,偶爾少一秒不影響 60 秒平均。
資料格式(一行一秒)
D,<ms>,<step>,<heater_c>,<gas_ohm>,<temp_c>,<rh_pct>,<pressure_hpa>,<ethanol_raw>,<h2_raw>,<tvoc_ppb>,<eco2_ppm>,<co2_ppm>
D,63000,1,240,118342.0,25.31,56.20,1011.42,17520,13210,12,410,468
接收程式 record.py
python record.py --list-ports                                   # 找序列埠名稱
python record.py --serial COM3 --monitor                        # 只看即時數值,不存檔
python record.py --serial /dev/tty.usbserial-XXXX --out data/2026-11-03_E1/raw.csv
python record.py --udp 5005 --out data/2026-11-03_E1/raw.csv    # WiFi
程式會問樣本編號,然後帶你走「換氣 120 秒 → 放入樣本按 Enter → 量測 240 秒 → 取出按 Enter → 回復 300 秒」。每一筆資料都會標上 sample_id、phase(purge/sample/recover)和階段內的秒數。等你按 Enter 的時間(開盒、放樣本)不會存,避免把開盒時的空氣算進基準。時間可以用 --purge --sample --recover 調整(E1 量完回復時間後可以縮短)。
從原始值到特徵
每次量測要變成一列「特徵」才能給模型。自己手打一份 labels.csv(每個樣本一列),和 raw.csv 放同一個資料夾:
# E1–E4 校正實驗
sample_id,label,concentration,rh_level,date
C0001,ethanol,1.0,mid,2026-11-03
C0002,acetic_acid,0.5,mid,2026-11-03

# E7 香蕉實驗
sample_id,batch,banana,storage,day,label,brown_pct,brix,ph,weight_loss_pct,inedible_votes
B1-r03-d04,1,B1-r03,room,4,ripe,6.5,,,3.1,0
然後執行 python experiments/make_features.py data/2026-11-03_E1,得到 features.csv。每次量測的 8 個氣味特徵:
| 特徵 | 算法 |
|---|---|
bme0…bme4 | 每段加熱溫度:(樣本最後 60 秒平均 − 換氣最後 60 秒平均) ÷ 換氣平均 |
ethanol、h2 | SGP30 原始訊號,同上的相對變化量 |
co2 | CO₂ 增加量(ppm ÷ 1000)。SCD40 是光學式、會自我校正,不需要相對化 |
env_temp、env_rh | 溫濕度,只記錄、不進模型,E4 用來分析濕度影響 |
用「相對變化量」的原因:金屬氧化物感測器的基準每天會飄,同一瓶酒精今天和明天的原始電阻不同,但相對變化量接近(E1b 就是在驗證這件事)。
蕈狀體模型程式:把果蠅的聞法寫成程式
三層各做什麼
| 層 | 果蠅 | 程式(enose/mushroom.py) |
|---|---|---|
| PN 投射神經元 | 觸角葉的側向抑制讓濃度不影響「氣味形狀」 | projection_neurons():除以典型大小 → 除以總和(增益控制)→ 扣掉平常的模式(適應)→ 拆成上升(ON)與下降(OFF)兩個 PN;判斷熟成時再加強度神經元 |
| KC Kenyon 細胞 | 每個 KC 收幾個 PN 的輸入;APL 神經元的全域抑制讓只有約 5% 放電 | kenyon_cells_code():drive = PN @ W.T,取最大的 5% 設為 1,其餘 0 |
| MBON 輸出神經元 | 多巴胺讓「剛放電的 KC → 輸出」的突觸改變 | partial_fit():只累加到正確類別那一區(分區學習),再除以樣本數(恆定調節) |
模型設計重點(可以寫進討論)
① APL 本身就有濃度不變性
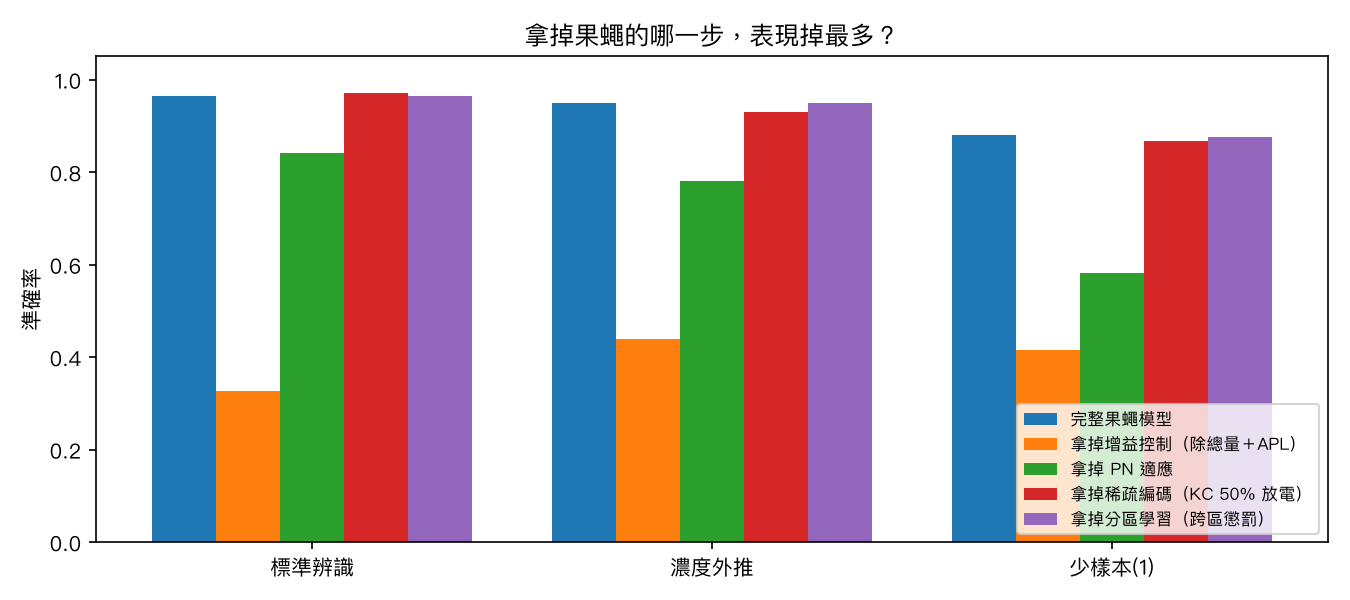
「只留前 5%」只看排名,輸入乘 2 倍排名不變。所以消融組要把「除以總量」和 APL 一起拿掉(normalize=False, kc_mode="threshold")。
② PN 適應的作用
扣掉「平常的氣味模式」讓標準辨識從 0.84 提升到 0.96、每類 1 個樣本從 0.58 提升到 0.88(模擬消融)。「平常」可以從沒有標籤的背景量測學,就像果蠅平常聞過很多東西但沒有獎懲。
③ 腐敗要看強度
增益控制會丟掉「多強」,但香蕉腐敗主要是乙醇和 CO₂ 變多。8 個各自偏好一段強度的「強度神經元」讓香蕉準確率從 0.74(只看比例)提升到 0.91(模擬)。
④ 分區學習不會忘
每類有自己的多巴胺區(punishment=0),學新類別時舊類別的權重完全不變,測試 test_separate_dopamine_compartments_do_not_forget 驗證了這件事。
⑤ 恆定調節
每個輸出神經元把累積量除以自己看過的樣本數,否則樣本最多的類別(例如「可食」)幾乎每次都贏。
比較方法 enose/methods.py
真實果蠅連結體:把雄果蠅大腦的接線放進模型
male-cns:v1.0,以 CC-BY 4.0 授權公開。來源:Google Research 部落格、doi:10.1016/j.cell.2026.08.015、male-cns.janelia.org
我們用連結體的哪一部分
只用嗅覺路徑中的一段:觸角葉投射神經元(PN)→ 蕈狀體 Kenyon 細胞(KC)的突觸。教科書的蕈狀體模型假設「每個 KC 隨機接 7 個 PN」,現在可以換成真實果蠅的接線,看看結果有沒有差別(實驗 E2c)。
| 資料中的名稱 | 意思 |
|---|---|
class == "ALPN" | 觸角葉投射神經元。單一嗅小球的 PN 命名為「嗅小球_譜系PN」,例如 DM4_adPN、V_ilPN;M_…、含 + 的是多嗅小球 PN,程式會略過 |
class == "Kenyon_Cell" | Kenyon 細胞,類型如 KCg-m、KCab-s、KCa'b'-m |
type == "APL" | APL 神經元(每側一個),就是我們模型裡「只留前 5%」的由來 |
class == "MBON" | 蕈狀體輸出神經元(MBON01…) |
somaSide | R/L,本研究用右腦 |
取得接線資料的三種方法
| 方法 | 需要 | 指令 |
|---|---|---|
| A. 直接用專案附的檔(建議) | 什麼都不用 | python experiments/connectome_wiring.py |
| B. neuPrint API | 免費 token:到 neuprint.janelia.org 用 Google 登入 → 右上帳號 → Auth Token | export NEUPRINT_APPLICATION_CREDENTIALS=<token>python experiments/connectome_wiring.py --source neuprint |
| C. 公開 Feather 檔 | 不用 token,但要下載約 1.1 GB | 從 male-cns.janelia.org/download 下載 body-annotations-…feather 與 connectome-weights-…feather 到 downloads/python experiments/connectome_wiring.py --source files |
專案附的 kc_glomerulus_R.csv 是用方法 C 從 male-cns v1.0 抽出來的。方法 B 的程式已寫好,但還沒有用真的 token 測試過。
# 方法 B 的核心(enose/connectome.py)
from neuprint import Client, NeuronCriteria, fetch_adjacencies
client = Client("neuprint.janelia.org", dataset="male-cns:v1.0", token=token)
neurons, connections = fetch_adjacencies(NeuronCriteria(class_="ALPN"),          # 來源:PN
                                         NeuronCriteria(class_="Kenyon_Cell"),   # 目標:KC
                                         properties=["type", "instance", "class", "somaSide"],
                                         client=client)
# connections 的欄位:bodyId_pre, bodyId_post, roi, weight(突觸數)
真實果蠅的接線長什麼樣
載入統計中…
電子鼻的 PN 要對應到哪個嗅小球?
我們的感測器不是果蠅的嗅覺受器,所以「哪個感測通道 = 哪個嗅小球」大部分是工程上的選擇,不是生物事實。程式把對應寫在 channel_map.csv,可以打開來看、也可以改:
- co2+ → V 嗅小球:果蠅的 CO₂ 受器神經元(Gr21a/Gr63a)只送到 V 嗅小球(Suh 等人,2004),這一個有生物根據。
- 其他 15 個 PN → 依「送到 KC 的突觸數」由多到少分配嗅小球。
- 文獻中醋酸會活化 DC4、DP1m、DP1l,乙酸乙酯會活化 DM4、DM1,但我們的感測通道不是單一氣體通道,所以沒有硬套。乙醇在果蠅上找不到明確對應的嗅小球。
載入對應表中…
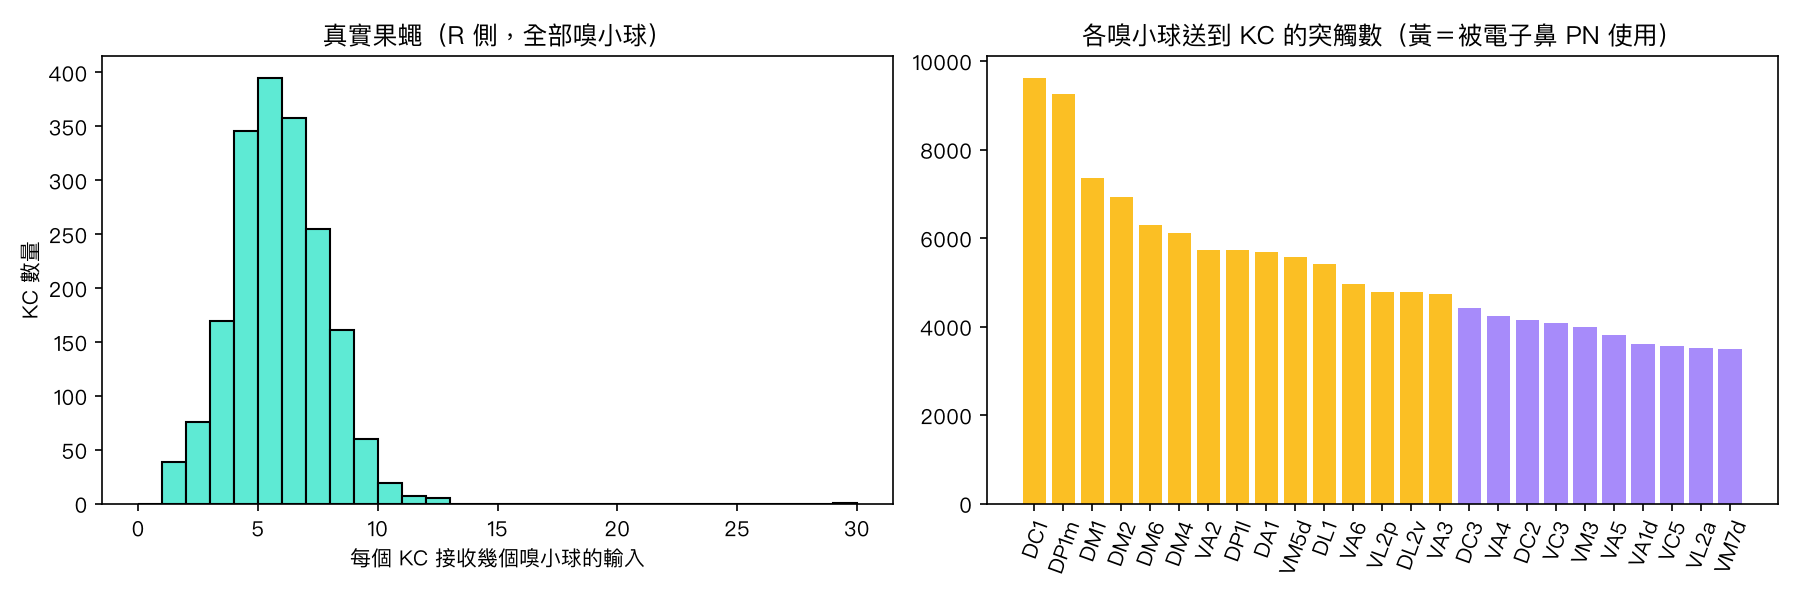
真實資料的樣子:右腦 1,891 個 KC 收到 54 個嗅小球的單一嗅小球 PN 輸入,每個 KC 接收的嗅小球數中位數是 5,和「每個 KC 約 5–7 個爪(claw)」的描述一致;V 嗅小球(CO₂)確實有 1,633 個突觸送到 KC,所以 co2+ → V 的生物對應可以成立。只取電子鼻用到的 16 個嗅小球時,有 1,784 個 KC 至少收到其中一個的輸入,平均 2.7 個。
模擬資料試跑:校正資料上連結體 0.97、打亂 0.97 ± 0.01、隨機 0.96;香蕉資料上連結體 0.71、打亂 0.71 ± 0.02、隨機 0.75 ± 0.01。兩份資料上真實接線都沒有優勢,如果真實資料也一樣,就照實寫「在這個任務上,果蠅的特定接線沒有額外好處」。
enose/connectome.py 與 experiments/connectome_wiring.py
實驗程式總表(可搜尋、可篩選)
| 程式 | 類別 | 對應 | 輸入 → 輸出 |
|---|---|---|---|
| firmware/enose_logger.py | M5Stack | 全部實驗 | 感測器 → 每秒一行資料(USB 或 WiFi) |
| firmware/enose_classifier.py + mb_infer.py | M5Stack | 現場展示 | enose_model.json → 螢幕顯示判斷與信心度 |
| record.py | 資料處理 | 全部實驗 | USB/UDP → raw.csv(含 SOP 階段標記) |
| experiments/make_features.py | 資料處理 | 全部實驗 | raw.csv + labels.csv → features.csv |
| experiments/make_demo_data.py | 資料處理 | 練習 | → 模擬的 raw.csv + labels.csv |
| experiments/browning_area.py | 資料處理 | E7 標準答案 | 香蕉照片 → 褐斑面積 % |
| experiments/e1_sensor_characteristics.py | 實驗分析 | E1 感測器特性 | raw + labels → 上升/回復時間、CV、反應曲線 |
| experiments/e1c_receptor_diversity.py | 實驗分析 | E1c 組合編碼 | features → 受器種類 1→8 種的準確率 |
| experiments/e1b_drift.py | 實驗分析 | E1b 漂移 | raw + labels → 每日基準、扣基準前後的跨日 CV |
| experiments/e2_compare_methods.py | 實驗分析 | E2 標準辨識、E9、E10 | features → 準確率表、混淆矩陣、PCA 圖 |
| experiments/e2b_ablation.py | 實驗分析 | E2b 元件消融 ★ | features → 拿掉每個果蠅機制後的三項準確率 |
| experiments/e3_concentration.py | 實驗分析 | E3 濃度外推 ★ | features → 只學 1 倍,各濃度準確率 |
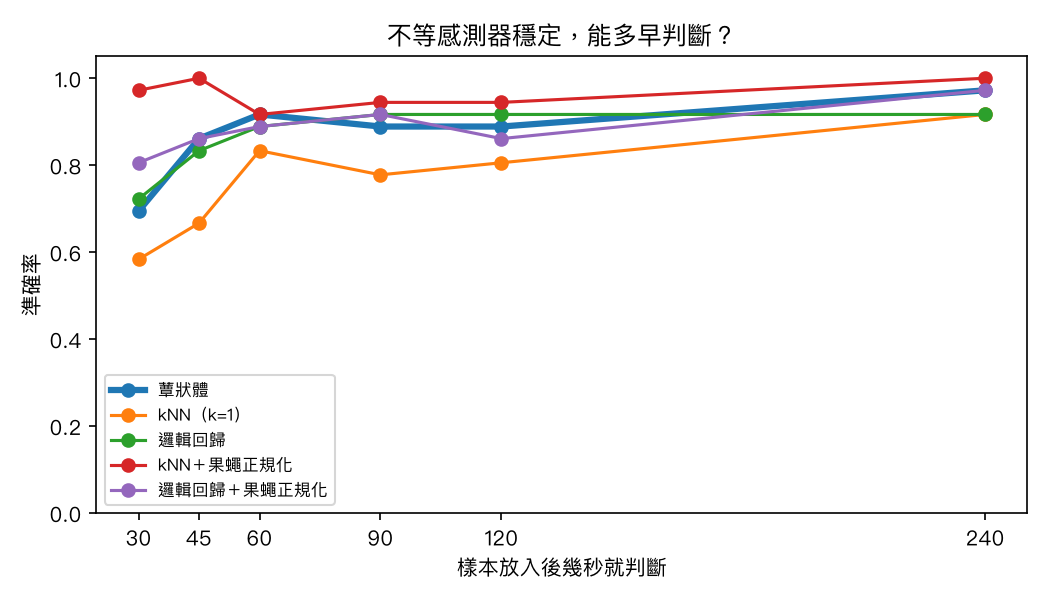
| experiments/e4_early_decision.py | 實驗分析 | E4 提早判斷 ★ | raw + labels + features → 30–240 秒的準確率 |
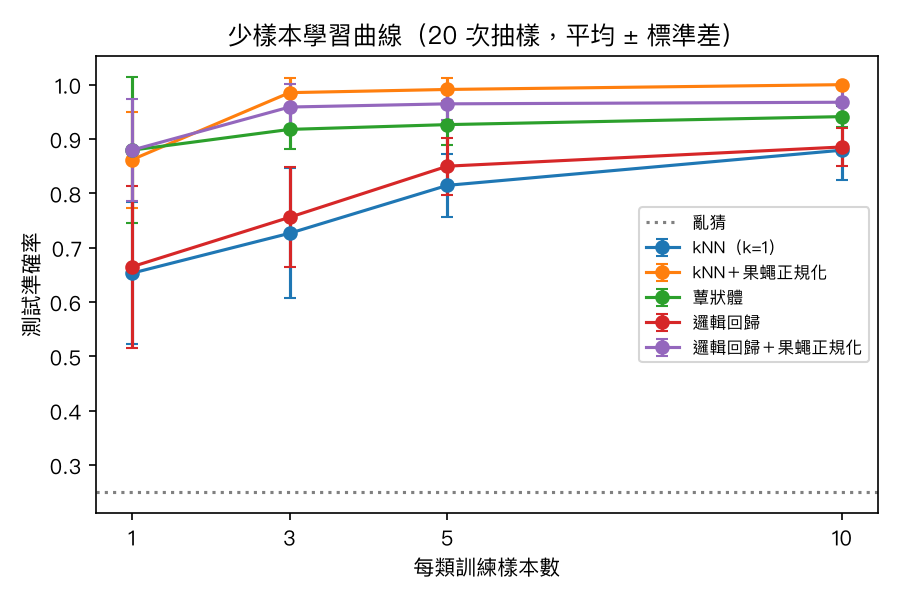
| experiments/e5_few_shot.py | 實驗分析 | E5 少樣本 ★ | features → 學習曲線(1/3/5/10 樣本 × 20 次,測試含各濃度) |
| experiments/e6_continual.py | 實驗分析 | E6 不遺忘 ★ | features → 學新類別前後的舊類別準確率 |
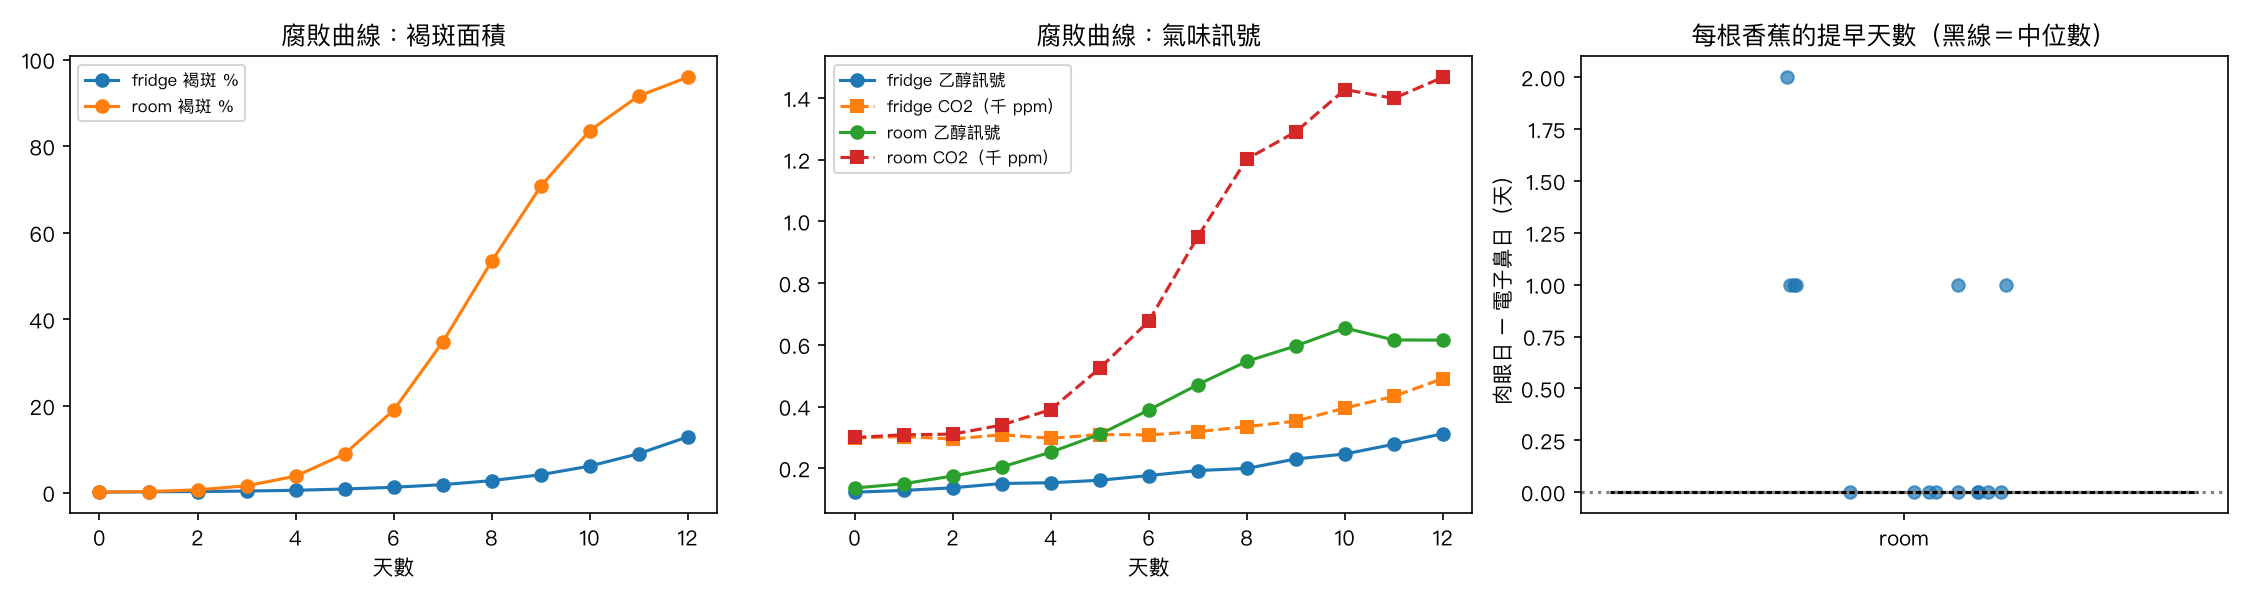
| experiments/e7_banana.py | 實驗分析 | E7 香蕉腐敗 | features → 逐批預測、提早天數、腐敗曲線 |
| experiments/e7b_correlation.py | 實驗分析 | E7b 相關 | features → 氣味 × 糖度/pH/褐斑相關熱圖 |
| experiments/e8_humidity.py | 實驗分析 | E8 濕度 | features → 高/低濕度下的準確率 |
| experiments/connectome_wiring.py | 連結體 | E2c | male-cns v1.0 → kc_wiring.npy、channel_map.csv |
| experiments/e2c_connectome.py | 連結體 | E2c | features → 隨機/連結體/打亂接線的準確率 |
| experiments/export_for_m5stack.py | M5Stack | 移植 | features → enose_model.json |
各實驗怎麼跑
每支程式都可以加 -h 看說明。以下指令在 code/ 資料夾執行。★ 是果蠅核心實驗,全部重用同一份 E1 資料,不必另外量。完整設計見研究計畫的實驗總表。
E1 感測器特性(6 種稀釋)、E1b 漂移、E1c 組合編碼
python record.py --serial COM3 --out data/E1/raw.csv       # 每天量,都附加在同一個檔
# 手打 data/E1/labels.csv:sample_id,label,concentration,rh_level,date
#   concentration 用 0.1 / 0.25 / 0.5 / 1 / 2 / 4;rh_level 用 low / mid / high
python experiments/make_features.py data/E1
python experiments/e1_sensor_characteristics.py data/E1
python experiments/e1b_drift.py data/E1 --gas ethanol --concentration 1.0
python experiments/e1c_receptor_diversity.py data/E1
11 月第 1 週決策點:先量 0.25、1、4 倍各 3 次,就跑 make_features.py 和 e3_concentration.py。如果果蠅模型在 0.25 或 4 倍明顯不行,代表真實感測器的比例會隨濃度改變,要回報並討論是否加 PN 非線性、縮小濃度範圍。
★ E2 標準辨識(非劣性)與 E2b 元件消融
python experiments/e2_compare_methods.py data/E1 --group date
python experiments/e2b_ablation.py data/E1 --group date
E2 看果蠅模型和最好的傳統方法差幾個百分點(H1:≤ 5)。E2b 一次拿掉一個果蠅機制,看哪一項能力掉最多:這是回答「果蠅的每一步有什麼用」的關鍵實驗。
★ E3 濃度外推
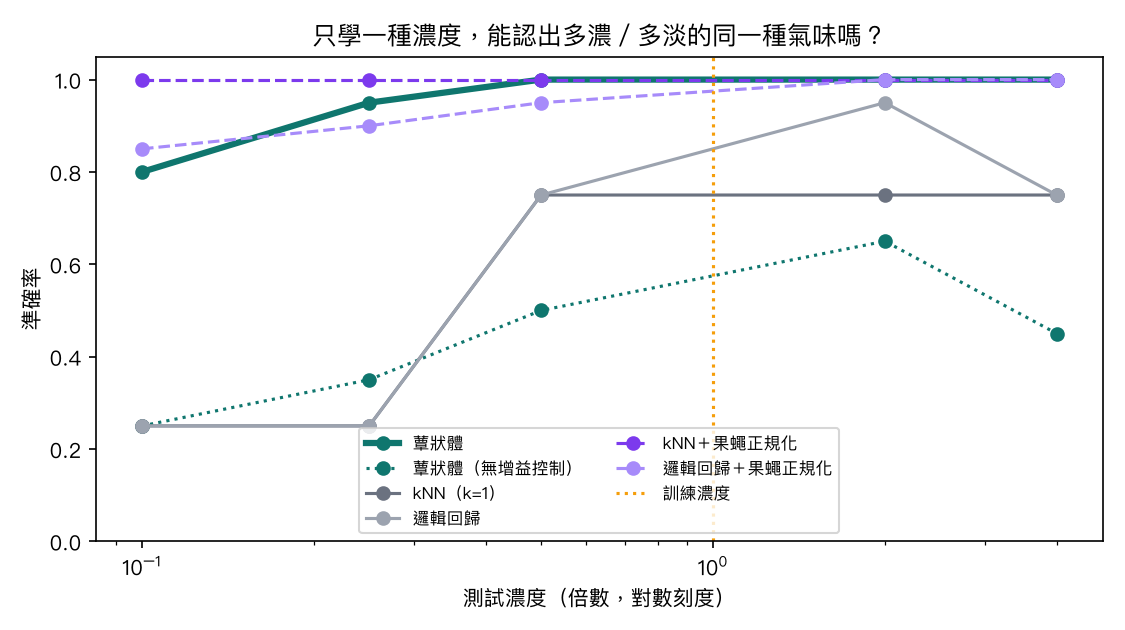
python experiments/e3_concentration.py data/E1 --train-concentration 1.0只用 1 倍濃度訓練,測 0.1–4 倍。圖上同時畫出「傳統方法+果蠅正規化」:如果它也變好,代表果蠅的原理可以移植,這也是正向結論。
★ E4 提早判斷
python experiments/e4_early_decision.py data/E1 --test-days 2不用重量:把原始記錄在樣本放入後 30–120 秒截斷,用截斷前 15 秒的平均,看多早就能判斷。若 60 秒就夠,E7 的量測時間可以縮短。模擬中 60 秒時各方法都有 0.83–0.92,果蠅模型沒有專屬優勢,30 秒時反而較差,所以這是「實用目標」而不是果蠅假設。
★ E5 少樣本
python experiments/e5_few_shot.py data/E1 --group date --shots 1 3 5 10每類只給幾個樣本(從各種濃度抽),測試集也包含各種濃度。所有方法都能用訓練日的無標籤資料做標準化/適應,比較才公平。
★ E6 不遺忘
python experiments/e6_continual.py data/E7 --group batch --new-class rotten先學新鮮/可食/過熟,再只學腐敗。比較:果蠅模型(分區學習)、果蠅模型(跨區懲罰,消融)、逐步更新的邏輯回歸。分區學習時舊類別的突觸完全不變,所以準確率只會因為「多了一個競爭者」而小幅下降。
E7 香蕉腐敗、E7b 相關分析、褐斑面積
python experiments/browning_area.py photos/day04 --out data/E7/browning_day04.csv --preview
# 把 brown_pct 等填進 data/E7/labels.csv
python experiments/make_features.py data/E7
python experiments/e7_banana.py data/E7                     # 果蠅模型+8 個強度神經元
python experiments/e7_banana.py data/E7 --intensity-pns 0   # 只看比例(H6 的對照)
python experiments/e7b_correlation.py data/E7
腐敗主要是「味道變強」,只看比例的果蠅模型會把強度丟掉,所以判斷熟成要加上強度神經元(H6)。提早天數的定義見研究計畫。
E2c 真實連結體 vs 隨機接線(探索)、E8 濕度
python experiments/connectome_wiring.py
python experiments/e2c_connectome.py data/E1 --group date
python experiments/e8_humidity.py data/E1
E2c 在模擬資料上三種接線差不多(0.96–0.97),真實資料如果也一樣,就照實寫「在這個任務上,果蠅的特定接線沒有額外優勢」。
M5Stack 獨立判斷(現場展示用)
- 在筆電訓練並匯出:
python experiments/export_for_m5stack.py data/E7 --intensity-pns 8 --out firmware/enose_model.json(判斷熟成要加強度神經元;辨認氣體種類用--intensity-pns 0)(約 70–140 KB)。模型檔裡也存了加熱溫度、BME_PERIOD_S、換氣與量測秒數,M5Stack 會照這些設定量,跟訓練資料一致。記錄時若改過,匯出要加--bme-period、--purge、--sample。 - 用 UIFlow 2 的檔案管理,把
mb_infer.py、enose_model.json上傳到裝置,再把enose_classifier.py當主程式。 - 操作:按 A 開始換氣 120 秒 → 放入水果按 A → 量測 240 秒 → 螢幕顯示 FRESH/RIPE/OVERRIPE/ROTTEN 與信心度,同時從序列埠印出
RESULT,...。
test_firmware_inference.py 確認 M5Stack 版的特徵計算、每一筆的判斷與信心度(誤差 < 10−9),都和電腦版一致。KC 驅動值相同時兩邊都讓編號小的 KC 優先,否則信心度會差到 0.03。未驗證:ESP32 上的執行速度、記憶體、BtnA.wasPressed() 與 Speaker.tone() 的實際行為、模型檔的正確路徑。firmware/mb_infer.py
自動測試:測試的是「為什麼」
執行 python -m pytest -q。每個測試都對應一個研究上的理由:
| 測試 | 為什麼重要 |
|---|---|
test_parse_line_…ignores_boot_text | 開機訊息和資料共用序列埠,雜訊行絕不能變成資料 |
test_baseline_subtraction_cancels_day_to_day_drift | 感測器漂移 15% 時,特徵仍要一樣,否則跨日資料不能合併 |
test_one_shot_learning_on_separable_odours | 「學一次就會」是題目的核心主張之一 |
test_gain_control_makes_the_code_concentration_invariant | H3:2 倍濃度要得到一樣的 KC 編碼;拿掉增益控制後要不一樣 |
test_separate_dopamine_compartments_do_not_forget | H5:學新類別時舊類別突觸必須完全不變;跨區懲罰的消融組則會改變 |
test_intensity_pns_separate_same_pattern_at_different_strengths | H6:比例相同、只差強度的兩類,只看比例分不開,加強度神經元才分得開 |
test_rarely_active_pn_does_not_dominate_the_code | 金屬氧化物通道幾乎都往下掉,偶爾的一點點上升雜訊不能被放大成主要訊號 |
test_majority_class_does_not_win_every_vote | 香蕉各階段樣本數不同,少數類別不能被淹沒 |
test_only_uniglomerular_pns_get_a_glomerulus | 連結體裡多嗅小球 PN 不能被誤當成單一嗅小球 |
test_device_prediction_matches_sklearn_model | 現場展示的判斷必須和說明書的分析一致 |
疑難排解
| 狀況 | 可能原因 | 處理 |
|---|---|---|
M5Stack 顯示 UnitError | 某個 Unit 沒接好或位址被占用 | 重插 Grove 線;確認用的是分接器(Hub)不是 PaHub |
record.py 說 port 被占用 | UIFlow 網頁或 Arduino 序列埠監看視窗還開著 | 關掉其他程式,拔插 USB |
record.py 一直「還沒收到資料」 | 韌體沒在跑、TRANSPORT 設錯、WiFi 不同網段 | 先用 --monitor;UDP 確認 LAPTOP_IP 與防火牆 |
gas0…gas4 數字都一樣 | 讀到 BME688 快取值 | 把 BME_PERIOD_S 改成 4,匯出模型時加 --bme-period 4 |
| SGP30 前幾分鐘數值固定 | 感測器暖機 | 每天開機暖機 30 分鐘再量 |
make_features.py 說有缺值 | 某個階段太短,最後 60 秒內沒有某段加熱溫度的讀值 | 確認換氣至少 60 秒;檢查 raw.csv 該樣本 |
| 圖上的中文變成方塊 | 電腦沒有中文字型 | Windows 應有「Microsoft JhengHei」;Linux 安裝 Noto Sans CJK |
| E3 說「樣本不夠抽」 | 某類在訓練池少於 10 筆 | 多量幾次,或加 --shots 1 3 5 |
實作清單
- 筆電安裝 Python、建立 .venv、
pytest顯示 25 passed - 用模擬資料把 E1–E6 每支程式跑過一次,看懂每張圖
- M5Burner 燒 UIFlow 2、設定 WiFi、網頁編輯器連線
- 接上三個 Unit,執行 enose_logger.py,螢幕數值正常
- 確認 gas0–gas4 數值彼此不同(沒有讀到快取)
- 確認 SGP30 乙醇與氫氣欄位沒有對調(酒精棉片測試)
record.py --monitor用 USB 收到資料- (選做)改成 UDP,用 WiFi 收到資料
- 用清水跑一次完整 SOP,
make_features.py沒有缺值 - 執行 connectome_wiring.py,讀懂 channel_map.csv 的對應理由
- (選做)申請 neuPrint token,用方法 B 重建接線表並比對
- 拍 5 張香蕉照片,調好 browning_area.py 門檻並固定
- 匯出模型、上傳到 M5Stack,實測獨立判斷的速度與記憶體
勾選狀態只存在這台瀏覽器。